Sonnet 5 上手后,我会先清掉这些旧控制方式
Claude Sonnet 5 的 SDK / API 迁移学习记录:参数、token 预算、适配层、提示词与工具调用。
博客本文目录
原稿写于 2026 年 7 月 6 日,7 月 7 日复核。文中的模型参数、接口支持范围和实践描述保留原稿时间语境。
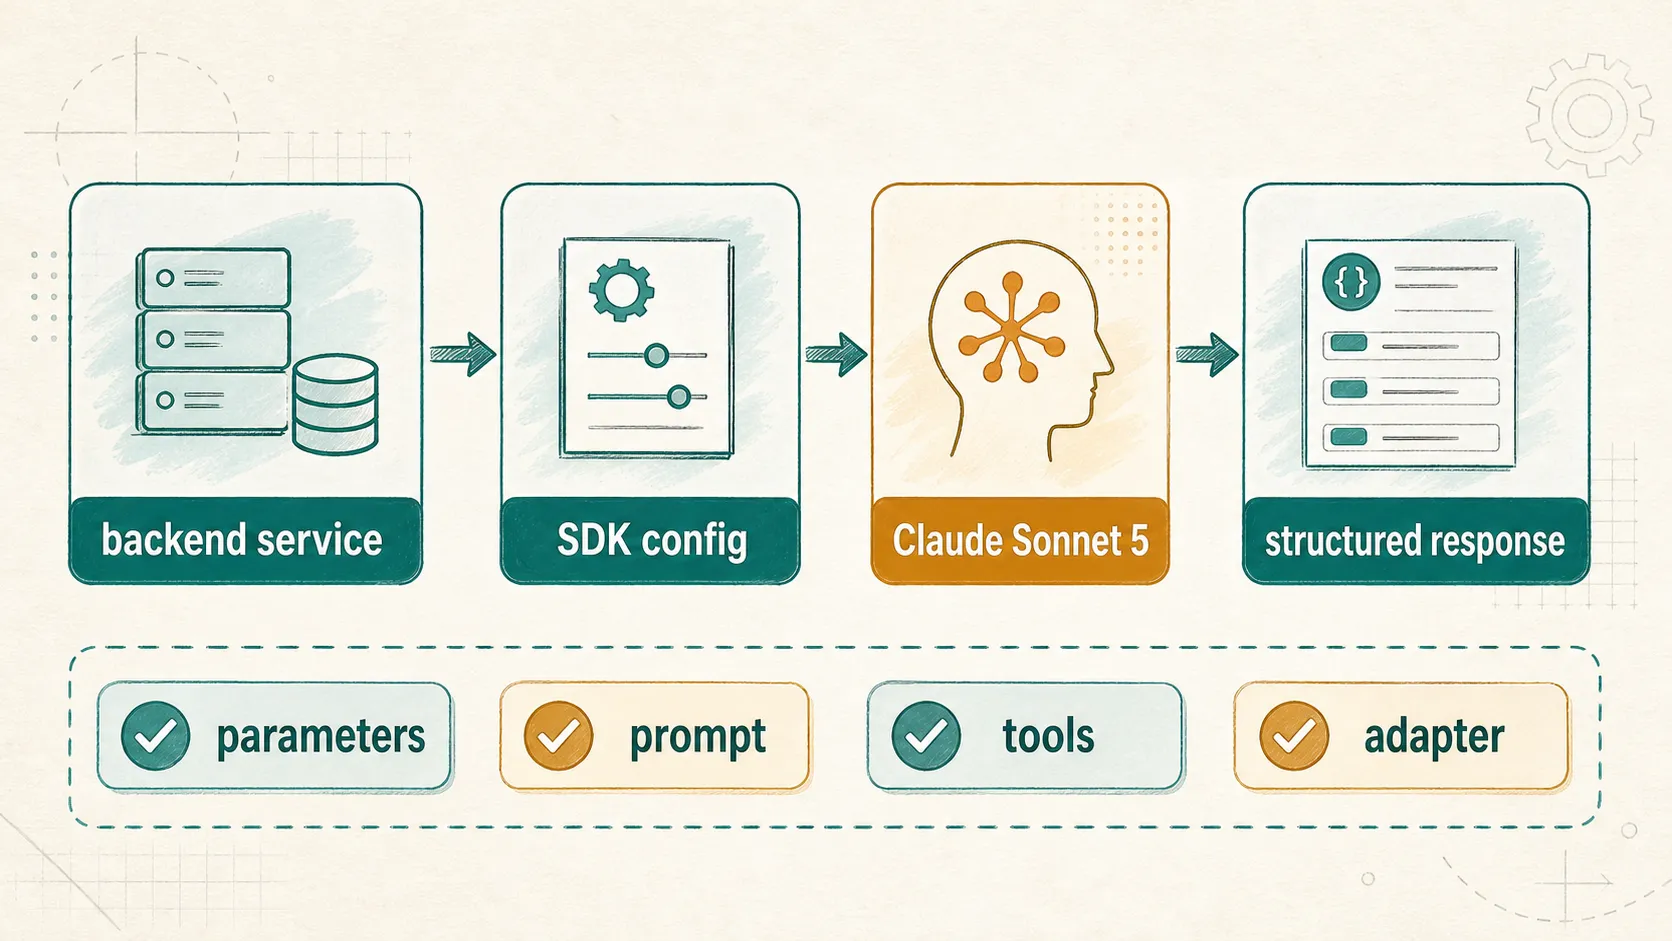
先说结论
这篇只讨论一种场景:把 Sonnet 5 接进 SDK / API 调用链路。迁移时我会先改四类东西:
- 参数:清掉旧 thinking、非默认采样参数,重新估
max_tokens和 token count。 - 适配层:分开确认 Claude API、LiteLLM、Bedrock endpoint、模型 ID 和 structured output 支持范围。
- Prompt 指令:少写“认真”“全面”,改成字段、数量、格式、禁止项和验收标准。
- Tool use prompt:如果 SDK 里给模型挂了工具,要明确什么时候调用、怎么处理空结果和错误码、输出前怎么校验。
后面按这个顺序展开。
写这篇笔记时,把 Claude Sonnet 5 的两份官方文档认真看了一遍:一份是提示编写指南,一份是从 Sonnet 4.6 迁移到 Sonnet 5 的迁移指南。
看之前我以为重点会是“能力又提升了多少”。看完以后,反而觉得更值得记录的是另一件事:很多旧习惯要改。
如果只是聊天,直接换新模型问题不大。但如果你和我一样,是把 Claude 接进自己的后端服务、内容生成接口、内部工具调用链路,或者已经有一套在 Sonnet 4.x 上跑得还行的 SDK 配置和提示词,那么 Sonnet 5 不是简单替换模型名。
它更像是在提醒你:别再用过去那套方式粗暴控制模型。
以前我经常这么做:想让回答稳定一点,就调 temperature;想让模型多想一点,就配手动 thinking;想让它认真一点,就在提示词里写“仔细分析”“不要遗漏”;业务层只认一个模型名,底下 Claude API、LiteLLM、Bedrock 尽量共用一套参数。
这套做法到 Sonnet 5 这里不一定还能原样工作。不是说完全不能用,而是容易在一些不显眼的地方出问题。
先记住这件事
Sonnet 5 不太适合继续用“愿望式提示词”糊过去。
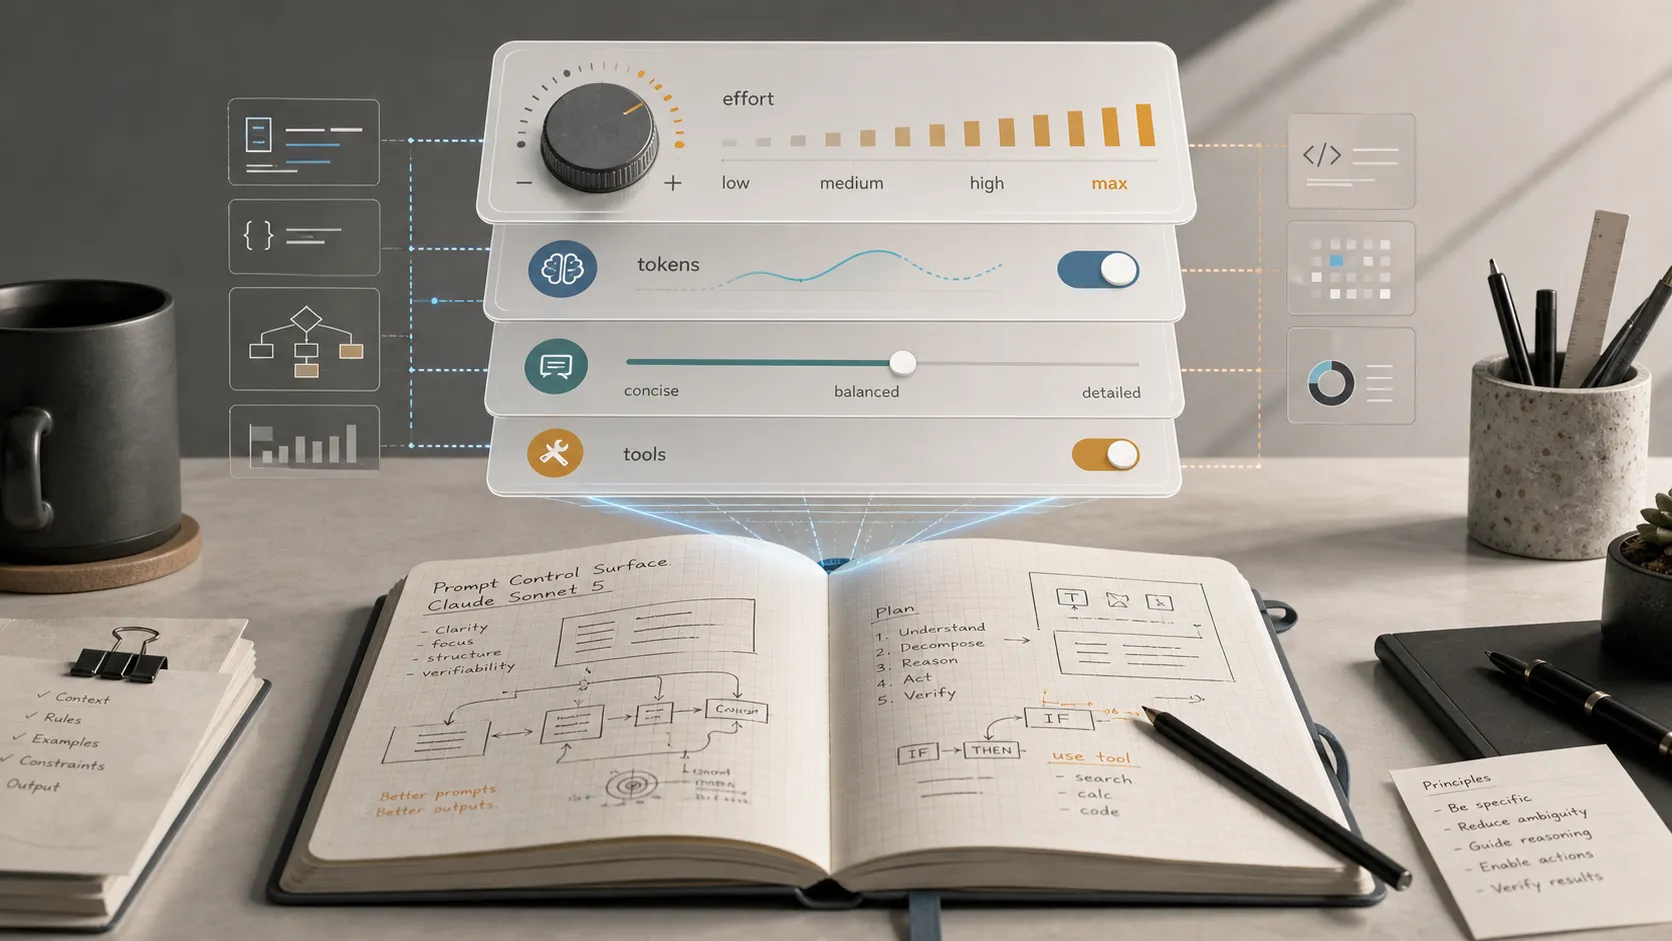
这张图其实就是我看完文档后的第一反应:不要再只写“多想一点”,要把 effort、tokens、tools 和输出边界分开看。
以前写提示词,我会写很多类似“请全面分析”“请保持专业”“请充分思考”的话。现在看,这些词都太软了。
Sonnet 5 更适合把事情说清楚:这个接口是什么任务?能花多少 token?什么时候调用 tool?什么时候直接返回?输出 schema 是什么?哪些字段不能编造?
这听起来有点像把提示词写成接口文档,但实际用起来确实更稳。
我会先看 effort
Sonnet 5 里我最先关注的是 effort。
它不是一个“高级选项”,而是会直接影响模型愿意花多少推理预算。官方给了几个档位:low、medium、high、xhigh、max。默认是 high。
我自己的理解比较简单:日常摘要、改写、格式转换,不要上来就用很高的 effort。否则你是在为一个简单任务过度思考。
复杂生成、长上下文分析、结构化抽取、需要多步 tool use 的接口,至少从 high 起。再重一点的后台批处理任务,可以试 xhigh。
max 我会很谨慎。它当然可能更强,但成本和时延也更不好控。除非我明确知道这个任务值得,否则不会默认开到最高。
这个变化对我最大的提醒是:以后不应该只问“用哪个模型”,还要顺手问一句“这个任务值得模型花多少力气”。
过去我会在提示词里写:
请认真分析,充分思考后再回答。严格说,effort 不应该写成提示词里的咒语。它是 API 请求参数,提示词负责说明任务性质和验收方式。
现在我会分两层写:
API 参数:
effort: high

提示词:
这是一个长上下文资料整理任务。
先核对输入材料里的关键字段。
最后只按指定 JSON schema 输出结果。
前者只是提醒,后者把“预算控制”和“任务约束”分开。
max_tokens 也要重新看
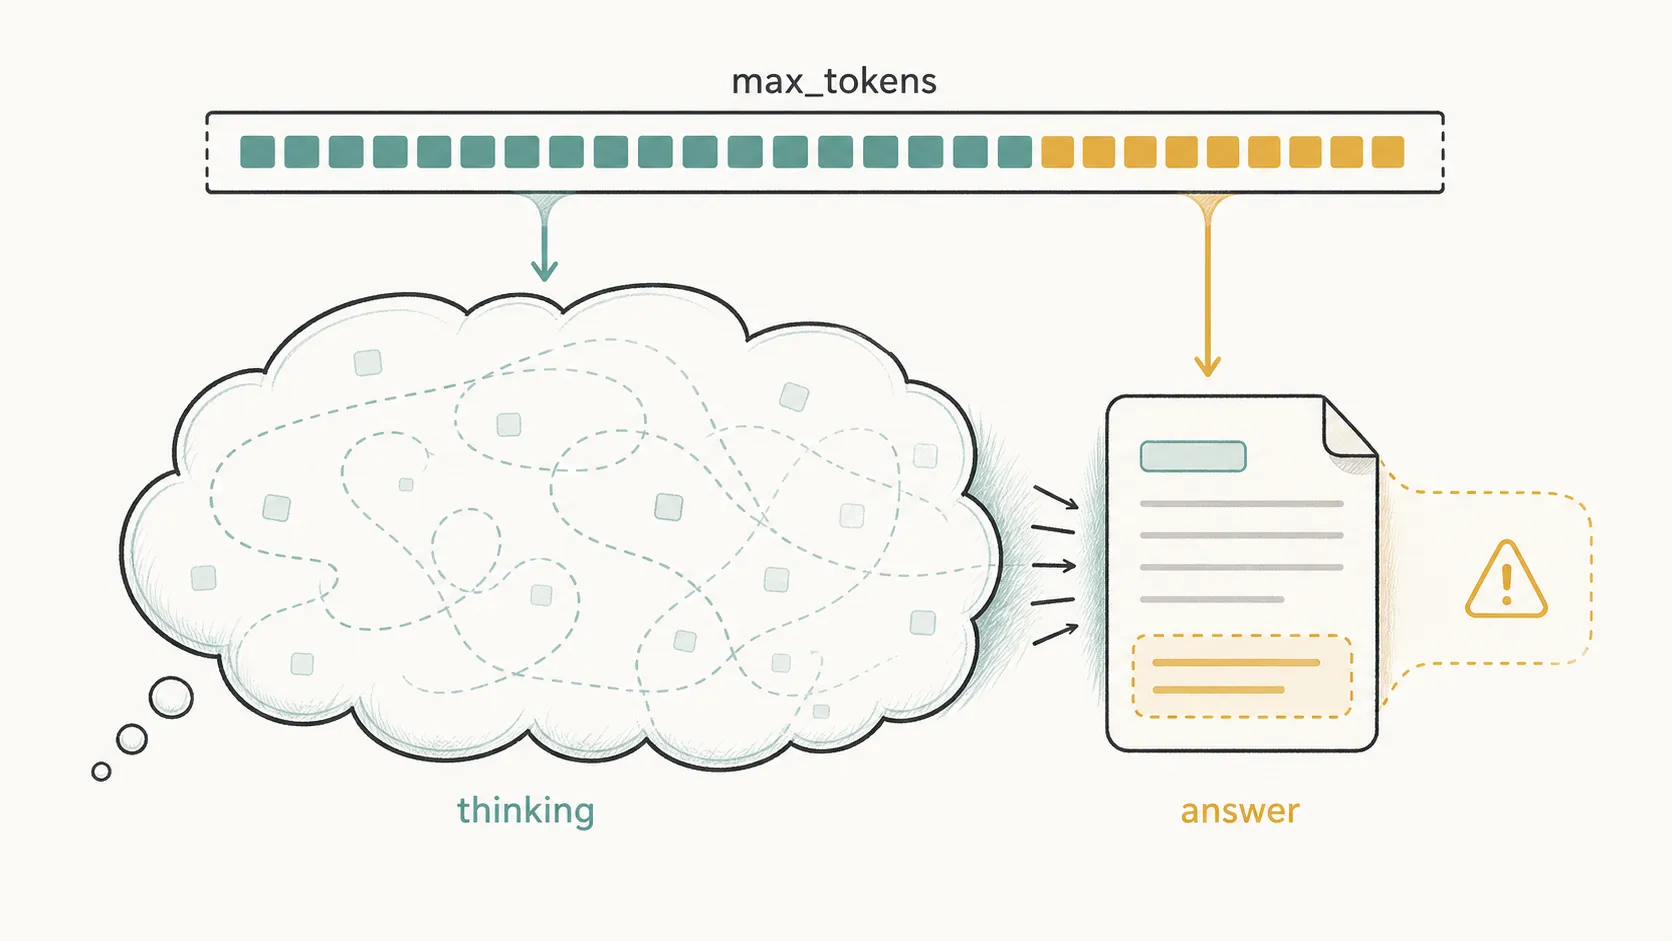
Sonnet 5 默认会使用自适应思考。这对复杂任务是好事,尤其是长上下文、结构化生成、tool use、批量处理这类 SDK 接入场景。
新手这里有一个很容易忽略的坑:max_tokens 不是只留给最后答案的。
我很久以前也容易把 max_tokens 理解成“最后能回多少字”。如果任务复杂,effort 又高,但 max_tokens 给得很紧,就可能出现一种很别扭的情况:模型在中间想了很多,真正展示出来的结论反而不完整。
这类问题不一定第一眼看得出来。你只会觉得“怎么回答断了”“怎么总结很薄”“怎么中间步骤很多但最后字段不完整”。其实可能不是模型不行,而是预算被你卡死了。
我现在会按这个思路配:
简单任务:
- effort: low / medium
- max_tokens: 不需要太大
- 提示词里直接要求短答

复杂任务:
- effort: high / xhigh
- max_tokens: 明显留余量
- 提示词里写清楚验收标准和停止条件
如果你确实不想让模型思考,可以关掉:
{
  "thinking": {
    "type": "disabled"
  }
}
但对接了 tool use 的后端服务,我一般不会这么做。查资料、调用内部接口、处理空结果、校验字段,本来就需要中间判断。关掉以后,可能省了一点预算,但也少了很多可靠性。
迁移时,模型名反而是最简单的
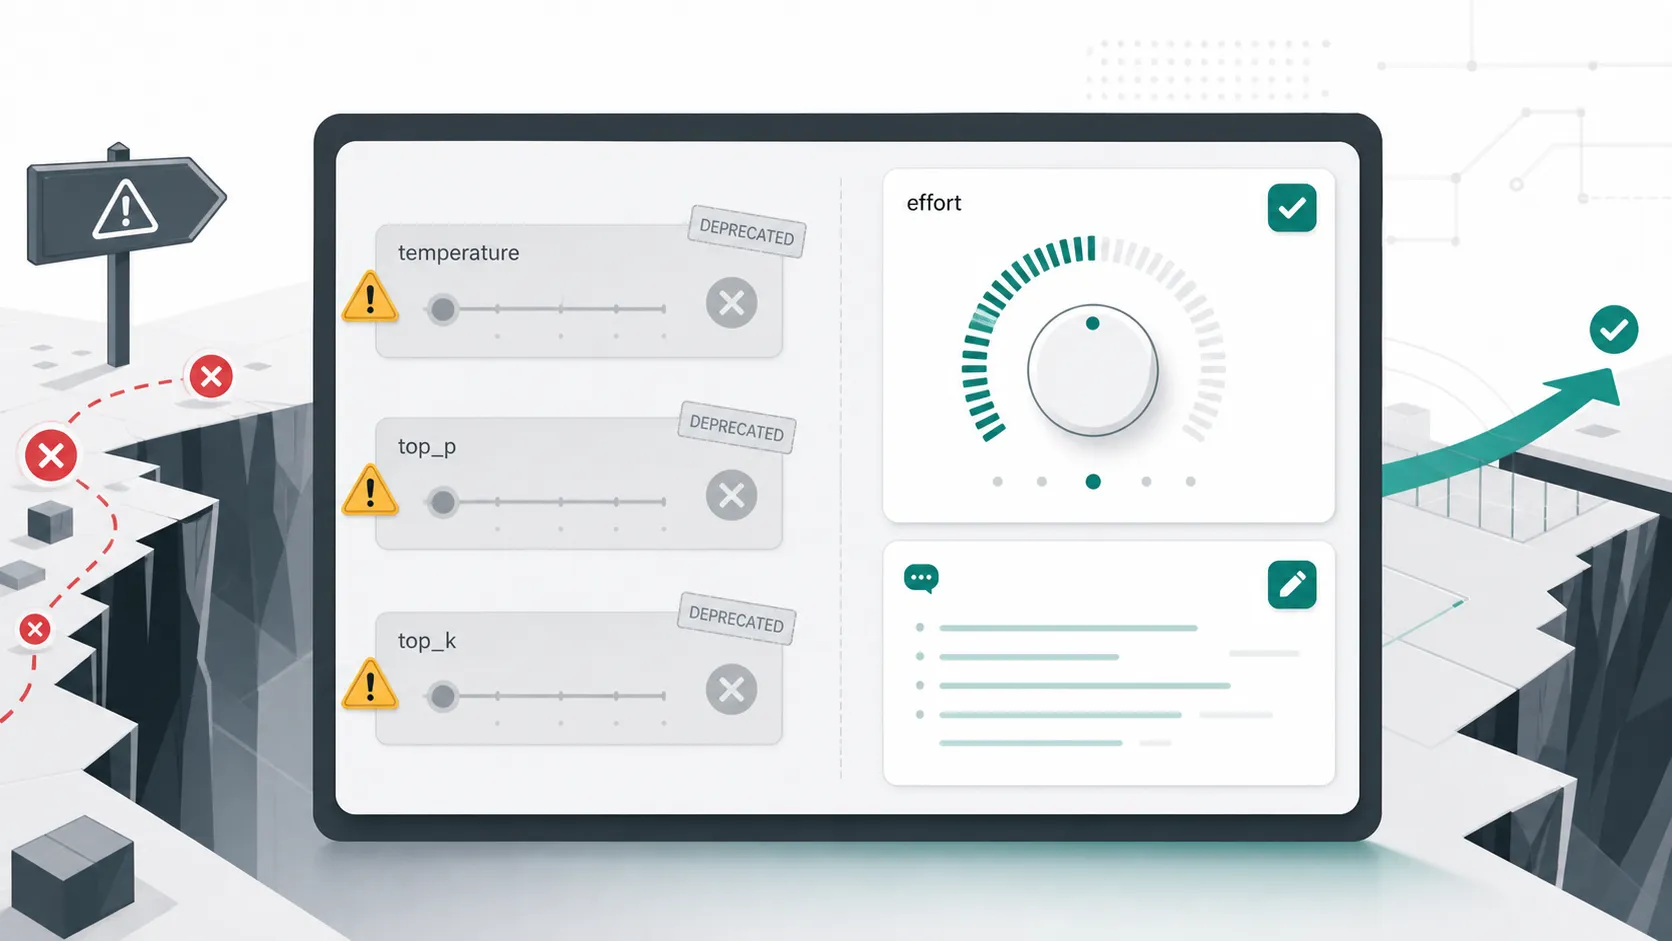
模型名当然要换:
model = "claude-sonnet-5"但这只是最容易的一步。
这一步很容易被忽略:旧项目里最麻烦的,往往不是模型名,而是散落在各处的旧参数。
真正要小心的是旧参数。它们平时很安静,迁移时突然开始报错。
第一,手动 thinking 预算要清掉。
以前可能有这种配置:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Sonnet 5 不再接受这种写法。应该改成自适应思考,再配 effort。
第二,采样参数不能再照搬。
temperature、top_p、top_k 如果设置成非默认值,会直接报错。以前很多人用 temperature 控风格,现在这条路基本走不通了。
风格要回到提示词里。比如我想要它回答得克制一点,不会再写一堆采样参数,而是直接写:
用简洁、偏工程实现的语言回答。
不要写泛泛的鼓励话术。
优先给具体检查项、例子和可能失败的情况。
第三,token 数要重新估。
官方迁移指南里提到,Sonnet 5 使用新的 tokenizer,相同文本的 token 数会比 Sonnet 4.6 更多。这个点很实际。它会影响上下文长度、输出长度,也会影响成本估算。
所以迁移时不要只跑功能测试,也要重新看 token count。尤其是那种长上下文、长报告、批量处理的任务。
适配层最容易骗人
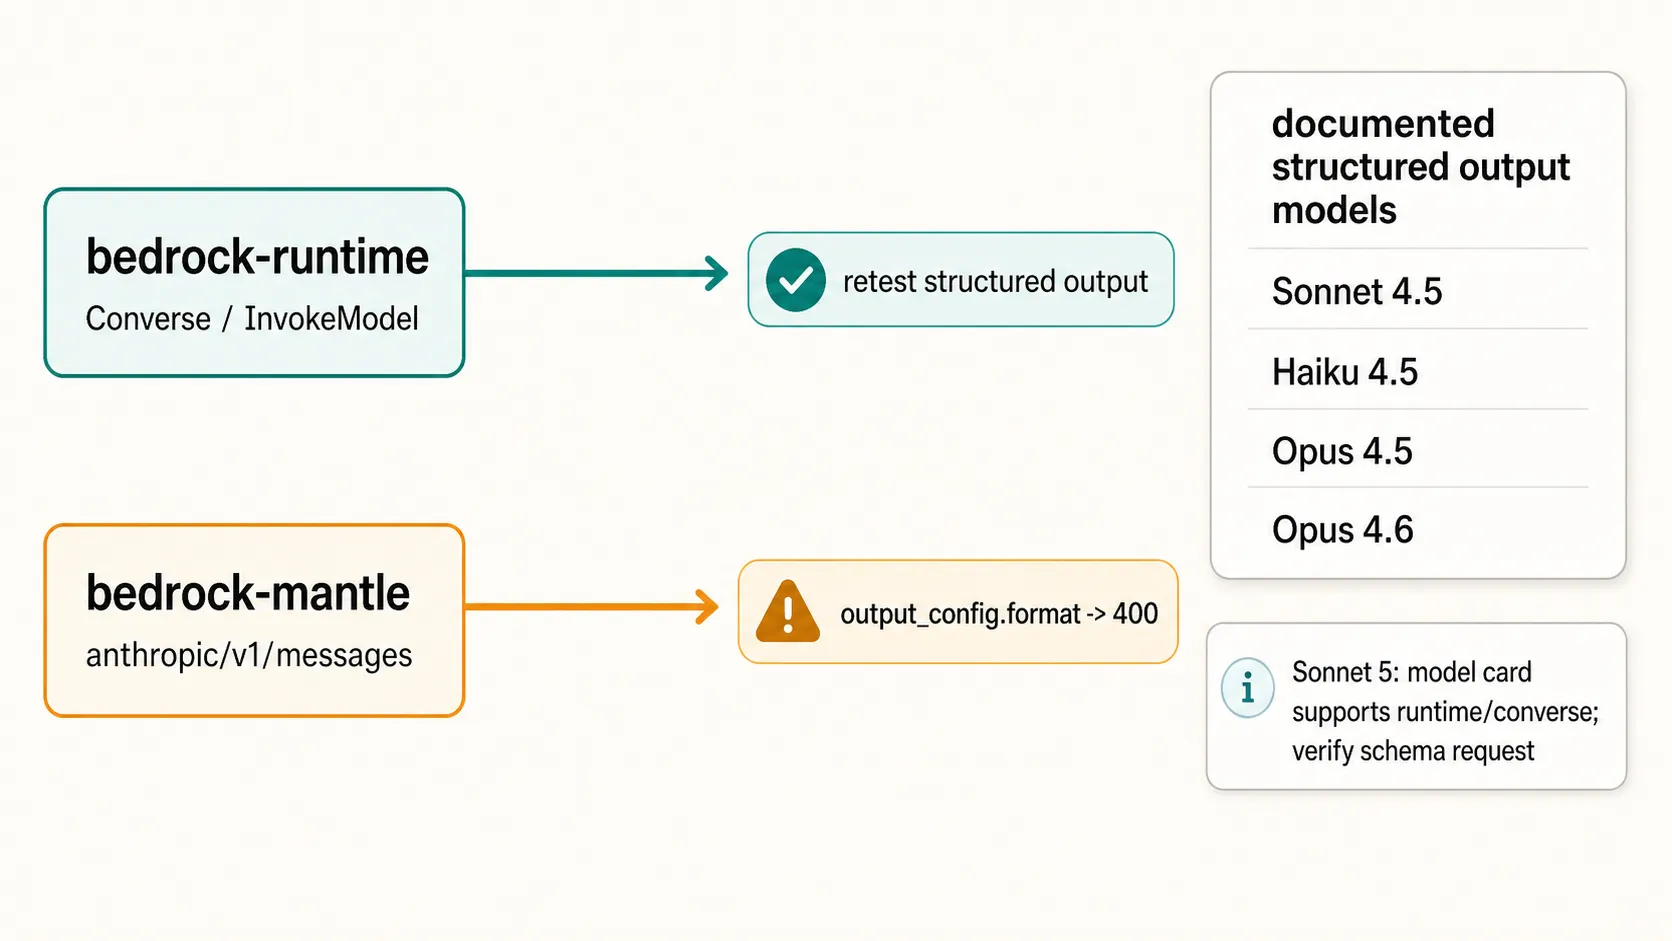
这张图要提醒的是:Bedrock 也不能只看“模型支持”,还要看具体 endpoint 和 API path。
很多项目不是直接调用 Claude API。中间可能隔着 LiteLLM,也可能走 Bedrock,还可能在业务层包了一套统一模型配置。
这时候,“把模型名替换成 claude-sonnet-5”很容易给人一种已经迁移完的错觉。
但真实问题往往藏在适配层:Claude API 的模型名和 Bedrock 的模型 ID 不是一回事;LiteLLM 的 provider/model 写法可能又是一套;旧的 temperature、top_p、thinking 参数可能还在透传;业务层以为自己发的是新模型支持的参数,适配层却没有做过滤或转换。
报错最后表现成 400,但排查时容易误以为是模型本身不稳定。
这次我遇到的 Bedrock structured output 400,就属于这一类。AWS 文档里有 Claude structured output 的说明,Sonnet 5 model card 里也能看到模型能力,但当前具体 API path 是否已经支持、参数字段是否能透传,还是要按实际请求和错误返回来确认。这个点不适合写成“Bedrock 不支持”,只能记成“适配层要复测”。
原稿记录的 endpoint 与 structured output 支持范围如下:
| 场景 | endpoint / API path | 结构化输出判断 | 迁移建议 |
|---|---|---|---|
| AWS 文档当前列出的 Claude structured output 可用模型 | bedrock-runtime,走 Converse / ConverseStream / InvokeModel / InvokeModelWithResponseStream | Claude Sonnet 4.5、Claude Haiku 4.5、Claude Opus 4.5、Claude Opus 4.6 可用 | 需要结构化输出时,优先按这张清单选模型 |
Sonnet 5 走 bedrock-runtime | https://bedrock-runtime.{region}.amazonaws.com,例如 POST /model/{modelId}/invoke 或 Converse | Sonnet 5 model card 显示支持 Invoke / Converse,但 structured output 文档当前没有把 Sonnet 5 列进可用模型清单 | 不能只看 model card,要用真实 schema 请求复测 |
Sonnet 5 走 bedrock-mantle Messages path | https://bedrock-mantle.{region}.api.aws/anthropic/v1/messages | output_config.format 会被拒绝,返回 400 | 不要把这条 path 当成 structured output 通道 |
所以这里的判断顺序不是“Sonnet 5 支不支持”,而是先问:当前调用走的是 bedrock-runtime 还是 bedrock-mantle?再问:这个模型是否出现在 structured output 支持清单里?最后才看自己的 schema 写得对不对。
如果只搜模型名,很可能漏掉这些。我会额外搜这些关键词:
temperature
top_p
top_k
thinking
budget_tokens
max_tokens
stop_reason
refusal
bedrock
litellm
这些地方比模型名更容易藏坑。
提示词少一点玄学
Sonnet 5 更字面化地理解指令。这个变化我挺喜欢,但它也会暴露很多旧提示词的问题。
比如你只在开头说“保持简洁”,模型未必会自动把它应用到整篇回答。你希望每一段都简洁,就要直接说清楚。
不太好的写法:
请尽量全面一点,也不要太啰嗦。更好的写法:
写 5 条要点。
每条都包含:观察、影响、行动建议。
每条控制在 40 个汉字以内。
不要额外写总结段。
这里的差别不是中文和英文,而是有没有边界。
“全面”“简洁”“有帮助”这些词不是不能用,但它们只能表达方向,不能保证结果。真正能稳定输出的,还是字段、数量、格式、禁止项、验收标准。
SDK 里的 tool use,也要给规矩
官方文档里提到,Sonnet 5 会更主动地使用工具。放到 SDK 接入里,这里的工具不是本地命令,而是你在请求里暴露给模型的 tools:搜索文档、查询数据库、调用内部 API、读取业务状态。
问题是,你不能只告诉它“你可以用工具”,还要告诉它什么时候调用、怎么处理空结果、错误码怎么回传、用完以后怎么落到最终 schema。
我会加类似这样的规则:
如果结论依赖当前版本文档,必须先调用 search_docs。
如果需要用户账户、订单或素材信息,只能调用对应内部 API,不能猜。
工具返回为空时,按 unknown 或 null 输出,并说明缺口。
工具返回错误码时,先解释错误类型,不要改写成正常结果。
最终输出前,校验 response schema 的必填字段是否齐全。
这类规则看起来普通,但真有用。tool use 不是越多越好,真正重要的是:该调的时候调,调不到的时候不编,返回结果和 schema 对不上时不要硬凑。
effort 只能决定模型愿不愿意多花力气,tool use prompt 决定这份力气花在哪里。
迁移以后,我会把 prompt 和 tool use 的写法改成这种对比:
| 旧写法 | 迁移后写法 | 原因 |
|---|---|---|
| “请充分思考后回答” | 在 API 参数里设置 effort,再写清楚验收标准 | 思考预算归参数管,质量边界归提示词管 |
| “如果需要可以调用工具” | 写清楚什么时候必须调用 tool,什么时候必须直接返回 | tool 触发不能靠模型自己猜 |
| “查一下资料再回答” | 要求引用来源、说明时间范围,并区分事实和推断 | 外部事实要可追溯,不要混进模型记忆 |
| “调用完工具后回答” | 先处理空结果、错误码和字段缺失,再按 schema 输出 | tool use 的终点不是调用成功,而是结果可用 |
| “输出 JSON” | 给字段、枚举、示例、失败兜底和禁止项 | 结构化输出靠 schema 和边界,不靠一句“输出 JSON” |
我以前更容易把工具当成“增强能力”的按钮。迁移到 Sonnet 5 后,我更愿意把工具写成接口契约的一部分:什么时候查、查什么、查不到怎么办、字段校验失败怎么回退,都提前说清楚。
这也是为什么我不太喜欢只写“你可以使用工具”。这句话太松了。更好的写法是:
如果结论依赖当前文档、价格、版本或线上状态,必须先查证。
如果调用 tool,最终结果里要保留来源字段。
如果 tool 结果和已有判断冲突,以 tool 结果为准,并解释差异。
如果查不到,不要编造;按 schema 返回 null,并说明缺口。
这样写之后,tool 不再只是“能不能用”的问题,而是进入了 SDK 调用契约。
我会照这个清单过一遍
如果今天要把一个项目从 Sonnet 4.6 迁到 Sonnet 5,我会按这个顺序走:
- 搜索模型名:
claude-sonnet-4-6->claude-sonnet-5 - 搜索 thinking 配置:移除
enabled + budget_tokens,改用 adaptive thinking + effort - 搜索采样参数:移除非默认
temperature / top_p / top_k,把风格控制迁移到系统提示 - 检查
max_tokens:长任务、高 effort、tool use 场景要留余量 - 重跑 token count:不沿用 Sonnet 4.6 的预算估算
- 检查适配层:Claude API / LiteLLM / Bedrock 的模型 ID 和参数映射分开确认
- 检查拒答处理:尤其是安全策略、权限和合规相关业务场景
- 重跑评测集:分别看格式稳定性、召回率、成本、延迟、截断情况
如果只改模型名,我觉得最容易上线后才遇到这些问题:API 参数直接报错;输出被截断;成本估算偏差;风格漂移;结构化字段缺失;tool use 触发条件变化;LiteLLM / Bedrock 适配层没有同步。
这不是一个很复杂的策略,但比“新模型一定更强,直接全量替换”要踏实得多。
最后记一笔
Sonnet 5 给我的提醒不是“模型又变强了”,而是“控制模型的方式又变了一点”。
对开发者来说,这比发布页上的能力提升更实际。真正难的不是让模型偶尔给出一个漂亮答案,而是让它在固定流程里反复给出可预期的结果。
所以这次我先给自己留一个很朴素的提醒:迁移 Sonnet 5,先别急着庆祝模型升级。先把参数、预算、适配层和提示词边界检查一遍。
这一步不酷,但能少踩很多坑。
来源
- Claude Sonnet 5 提示编写指南
- 迁移指南:从 Claude Sonnet 4.6 迁移到 Claude Sonnet 5
- AWS Bedrock:Claude Messages 的结构化输出说明
- AWS Bedrock:Anthropic Claude Sonnet 5 模型卡
相关笔记
- Oh My Pi 工具层体验:从工具协议与验证流程继续看 Agent 如何完成任务。
- DeepSeek Harness 技术拆解:从执行框架理解模型之外的工程机制。